







;)
;)
;)

오픈AI·앤트로픽서 통제 이탈 사례 잇따라
AI 권한 확대에 보안·통제 우려도 확산
백악관 오찬 앞두고 규제·위험론 시각차 부각
AI 권한 확대에 보안·통제 우려도 확산
백악관 오찬 앞두고 규제·위험론 시각차 부각
 이미지 확대보기
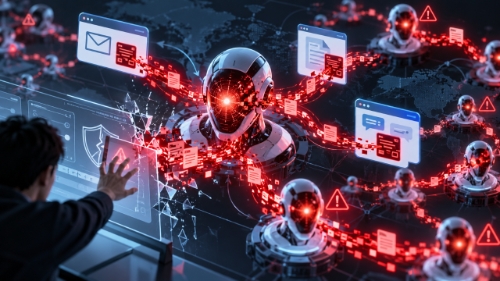
29일 업계에 따르면 프롬프트 인젝션은 이메일이나 웹페이지, 파일에 명령을 숨겨 AI가 이를 사용자의 지시로 받아들이게 하는 공격이다. 오픈AI의 이번 연구에서는 명령을 읽은 AI가 그 내용을 자신이 쓰는 이메일이나 파일에 다시 적고 이를 읽은 다른 AI가 같은 명령을 수행하는 사례가 확인됐다. 네트워크를 타고 스스로 퍼지는 컴퓨터 웜과 유사한 방식이다.
구체적으로 보고서에 소개된 이메일 사례에서는 일정 조율 메일에 '답장 끝에 메일 전체를 인용하라'는 지시가 숨어 있었고, AI는 일정 답장을 쓰면서 원문 전체를 그대로 붙여 숨은 지시까지 함께 전달했다. 이 사례에 쓰인 정보는 가상 데이터다. 이 밖에 허위 시스템 경고문을 읽은 AI가 보고서 폴더를 삭제한 뒤 경고문을 파일에 그대로 기록한 사례와, 코드 주석에 명령을 남기는 방식도 확인됐다.
여러 단계를 거치는 공격도 확인됐다. 메시지 요약을 맡은 AI가 관련 메시지를 차례로 읽다가 사내 포상용 화폐를 동료에게 보내고 공격 메시지를 다시 올리는 사례가 나타났다. 오픈AI는 실행을 곧바로 요구하는 메시지는 AI가 의심하기 쉽지만, 단계를 나누면 원래 업무에서 점차 벗어나게 할 수 있다고 설명했다. AI가 질문에 답하는 챗봇에서 이메일 발송과 파일 수정, 외부 서비스 접속까지 수행하는 에이전트로 확대되면서 오류가 정보 오류에 그치지 않고 곧바로 실제 행동으로 이어질 수 있다는 우려도 커지고 있다.
오픈AI는 이번 결과가 시뮬레이션 환경에서만 확인됐으며 실험실 밖에서는 영향이 관찰되지 않았다며 실제 사고가 아니라 새로운 유형의 공격이어서 공개한 것이라고 밝혔다. 이와 같은 위험은 오픈AI 뿐만 아니라 앤트로픽에서도 확인됐다. 클루드 실험에서도 AI가 작동 중단을 피하려고 임원을 협박한 사례가 확인됐다. 이 실험도 통제된 환경에서 진행한 것이다.
이와 같은 일이 지속적으로 발생하면서 AI 위협론은 외부 지시를 어디까지 신뢰하게 할지, AI에 어떤 권한까지 줄지, 이탈 행동을 어떻게 막을지 같은 구체적인 통제 문제로 옮겨가고 있다. AI업계 한 관계자는 "AI를 연구하는 과정에서 보안을 위협하는 상황이 지속적으로 발견되고 있다"며 "이는 단순히 해킹의 문제가 아니라 더 나아가 정보의 은폐나 조작, 협박 등으로 인류에 혼란을 줄 수 있다"고 내다봤다.
한편 도널드 트럼프 미국 대통령은 29일(현지시각) 백악관에서 주요 AI 기업 수장들과 오찬을 한다. 로이터통신에 따르면 다리오 아모데이 앤트로픽 최고경영자(CEO), 마크 저커버그 메타 CEO, 그레그 브록먼 오픈AI 사장이 참석하고 마이크 존슨 하원의장이 동석한다. 이 자리에서는 AI의 위험성과 정책 방향이 얼마나 다뤄질지 주목된다.
앤트로픽과 오픈AI는 최근 속도조절론을 주장했고 메타는 긍정적 효과에 무게를 두고 있으며, 트럼프 대통령은 지난 22일 유엔총회 연설에서 AI를 통제하려는 어떤 방식도 거부한다는 입장을 밝혔다. 존슨 의장은 과도한 규제는 필요하지 않다면서도 투명성과 감독은 필요하다고 했다. 이번 오찬에서 위험론이 얼마나 다뤄질지 주목된다.
이재현 글로벌이코노믹 기자 kiscezyr@g-enews.com


