








;)
;)
;)

오픈소스 승부수…24GB 일반 PC부터 4GB 초소형 기기까지 온디바이스 완벽 지원
클라우드 종속 끝내나…EY·스케일 AI 앞다퉈 도입한 '네모트론 3.5' 베일 벗었다
빅테크 AI 판도 흔들 '가중치 전면 개방'…보안과 속도 다 잡고 시장 장악 시동
클라우드 종속 끝내나…EY·스케일 AI 앞다퉈 도입한 '네모트론 3.5' 베일 벗었다
빅테크 AI 판도 흔들 '가중치 전면 개방'…보안과 속도 다 잡고 시장 장악 시동
 이미지 확대보기
[핵심 포인트]
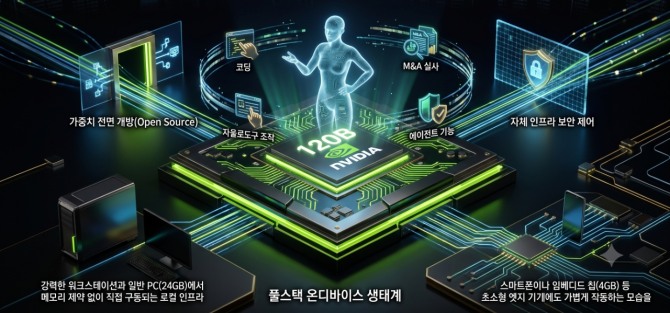
○ 복잡한 에이전트 작업을 수행하는 1200억 개 파라미터 규모의 '네모트론 3.5 슈퍼 VL'과 기기 내 직접 구동에 특화된 경량형 '볼트' 2종을 오픈소스로 공개했다.
○ 슈퍼 VL은 동급 경쟁 모델 대비 에이전트 작업 완료 속도가 5배 빠르며, 파라미터 수는 5분의 1 수준이면서도 최고 수준의 추론 정확도에 근접했다.
○ 고도의 양자화 기술을 적용해 24GB·4GB 등 제한된 메모리 환경의 로컬 PC나 엣지 기기에서도 고성능 에이전트를 원활하게 구동할 수 있도록 설계했다.
복잡한 다단계 워크플로우 처리…동급 모델 대비 5배 속도
엔비디아가 자율 인공지능(AI) 에이전트를 다양한 컴퓨팅 환경에 도입할 수 있도록 설계된 신규 오픈소스 AI 모델 제품군을 전격 공개했다. 이번에 발표된 라인업은 1200억(120B) 개의 파라미터를 탑재해 복잡한 워크플로우를 처리하는 플래그십 '네모트론 3.5 슈퍼 VL(Nemotron 3.5 Super VL)'을 중심으로, 로컬 하드웨어 구동에 최적화된 소형 변형 모델들로 구성됐다.
슈퍼 VL은 단순한 텍스트 생성을 넘어 시각 정보를 판독하고 외부 툴을 연계해 여러 단계의 복합 과업을 자율적으로 완수하는 기능을 갖췄다. 엔비디아 측은 해당 모델이 동급 경쟁 제품군에 비해 에이전트 작업 완료 속도가 5배 빠르다고 설명했다. 특히 매개변수 규모가 약 5분의 1 수준에 불과함에도 자사의 최상급 대형 추론 모델에 필적하는 정확도를 보인 점이 특징이다.
이러한 성능을 기반으로 장시간의 정밀 조사나 방대한 문서 분석 자동화가 필요한 기업 현장 도입도 빠르게 이어지고 있다. 스케일 AI(Scale AI)는 스카이댄스의 공급업체 금융 에이전트와 EY의 인수합병(M&A) 실사 에이전트에 슈퍼 VL을 맞춤 적용했다. 애프터쿼리(AfterQuery)는 헤비아의 신용 계약서 분석에 이 모델을 채택했으며, AI21과 앨리스(Alice)는 사이버 공격 복원력 강화 프로젝트에, 메르코르(Mercor)는 소프트웨어 엔지니어링 벤치마크(APEX-SWE) 기반 코딩 과업에 모델을 파인튜닝해 실전에 배치했다.
24GB·4GB 메모리 최적화…온디바이스 에이전트 '볼트' 출격
함께 공개된 '네모트론 3.5 볼트(Bolt)' 시리즈는 메모리 제약이 심한 하드웨어 환경을 겨냥해 원격 클라우드 인프라 의존도를 낮춘 온디바이스 에이전트 모델이다.
상위 변형 모델인 '볼트 74B-A9B'는 네이티브 2비트 양자화 기술을 적용해 24GB 메모리 환경 내에서 작동하도록 설계됐다. 일반적인 고성능 워크스테이션이나 PC에서 다른 애플리케이션과 함께 멀티태스킹으로 구동 가능하며, 로컬 코딩 지원이나 웹 검색 대행 작업에 유용하다. 해당 모델은 핀치벤치(PinchBench) 동급 오픈소스 부문 1위, 브라우즈컴프(BrowseComp) 2위를 기록했다.
초경량 모델인 '볼트 E4B'는 불과 4GB 메모리 용량으로 작동한다. 빠른 응답성이 필수적인 실시간 대화형 음성 비서나 대화형 캐릭터, 엔비디아 젯슨(Jetson) 기반의 임베디드와 물리적 AI 시스템을 타깃으로 한다. 볼트 74B-A9B는 현재 배포 중이며, 볼트 E4B는 오는 10월 23일 정식 출시될 예정이다.
26조 토큰 학습·가중치 전면 개방…자체 인프라 보안 제어권 확보
기업들은 엔비디아 네모(NeMo) 프레임워크와 파이썬 파이프라인을 활용해 자체 데이터로 모델을 미세조정할 수 있다. 민감한 내부 데이터를 외부 클라우드로 전송하지 않고 온프레미스 인프라에서 직접 모델을 운용할 수 있어 데이터 보안과 제어권을 크게 강화할 수 있다는 평가다.
현재 슈퍼 VL은 허깅페이스(Hugging Face), 오픈라우터(OpenRouter), 모델스코프(ModelScope) 및 엔비디아 AI 배포 플랫폼 NIM을 통해 제공된다. 볼트 74B-A9B는 허깅페이스에서 다운로드해 올라마(Ollama)나 LM 스튜디오(LM Studio) 등의 로컬 구동 툴로 즉시 실행할 수 있다. 향후 시장의 평가는 벤치마크 수치를 넘어 실제 엔터프라이즈 하드웨어 환경에서 메모리 과부하나 지연 시간 없이 얼마나 안정적인 결과물을 꾸준히 도출할 수 있는지에 집중될 전망이다.
이인수 글로벌이코노믹 기자 tjlee@g-enews.com


