







;)
;)
;)

GPU 제공 시대서 토큰 생산·판매하는 시대로 전환
엔비디아·AMD·텐스토렌트 등 이기종 가속기 기술 공개
엔비디아·AMD·텐스토렌트 등 이기종 가속기 기술 공개
 이미지 확대보기
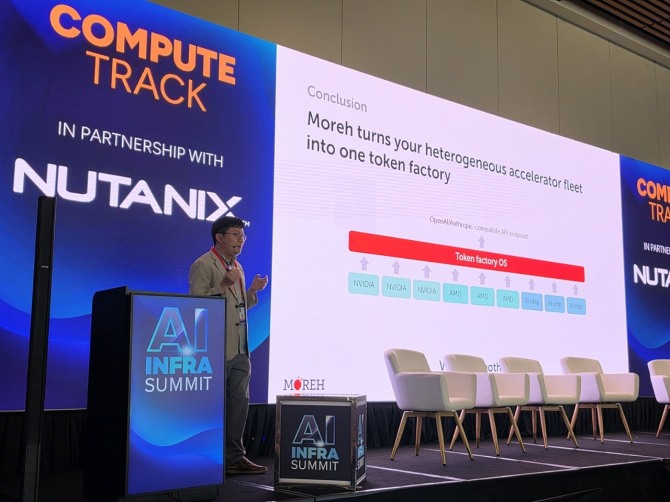
16일 모레에 따르면 조강원 대표는 15~17일(현지시각) 미국 산타클라라 컨벤션센터에서 열리는 'AI 인프라 서밋 2026'에 참가해 '이기종 가속기 데이터센터를 위한 대규모언어모델(LLM) 서빙 프레임워크'를 주제로 발표를 진행했다.
토큰 팩토리는 AI 데이터센터의 운영 기준을 GPU 용량이 아닌 토큰 생산으로 보는 개념이다. 기존에는 얼마나 많은 GPU를 확보하고 제공할 수 있는지가 중요했다면, 생성형 AI 확산 이후에는 같은 인프라에서 얼마나 많은 토큰을 생산할 수 있는지가 데이터센터 운영의 주요 기준으로 삼고 있다.
이를 위한 소프트웨어가 '토큰 팩토리 운영체제(OS)'다. 데이터센터에 있는 여러 종류의 가속기를 하나의 자원으로 묶고 모델과 요청 특성, 가속기별 연산 특성에 따라 추론 작업을 나눠 처리하도록 구성한다. 모레는 토큰 팩토리 구현에 이기종 가속기 기반 분산 추론 기술을 활용한다. 엔비디아와 AMD처럼 아키텍처가 다른 가속기나 최신 세대와 기존 세대 장비를 하나의 데이터센터에서 함께 운용하는 방식이다.
모레의 'MoAI 인퍼런스 프레임워크'는 이 같은 가속기들을 연결해 추론 과정에서 발생하는 작업을 장비별로 나눠 처리한다. 엔비디아와 AMD, 텐스토렌트 등 서로 다른 업체의 가속기를 한 시스템에서 함께 사용할 수 있도록 한 구조다. 실제 엔비디아 H100과 AMD MI300X를 결합한 사례에서는 프롬프트 처리를 H100이 맡고 응답 생성은 MI300X가 담당하도록 작업을 분리했다. 두 가속기 사이의 데이터는 모레의 분산 추론 소프트웨어로 연결했다. 그 결과 동일 벤더 기반 구성과 비교해 최대 1.67배의 처리량을 기록했다.
조 대표는 "AI 데이터센터는 이제 GPU를 제공하는 공간에서 토큰을 생산하고 판매하는 '토큰 팩토리'로 진화하고 있다"며 "중요한 것은 특정 GPU의 성능이 아니라 서로 다른 가속기를 얼마나 효율적으로 활용해 낮은 비용으로 토큰을 생산하느냐"라고 말했다.
모레는 AMD GPU 환경에서 AI 모델을 최적화해왔으며 GPU와 신경망처리장치(NPU)를 하나의 논리적 클러스터로 운용하는 기술과 서로 다른 가속기를 활용해 하나의 AI 모델을 실행하는 분산 추론 소프트웨어를 개발해왔다. 자회사 모티프테크놀로지스를 통해 AI 파운데이션 모델 분야도 다루고 있다.
이재현 글로벌이코노믹 기자 kiscezyr@g-enews.com


